Die nächste Hardware-Revolution: Software-defined Inferenz?
Was hinter den neuen „Probability Processing Units“ von Ludwig Computing steckt
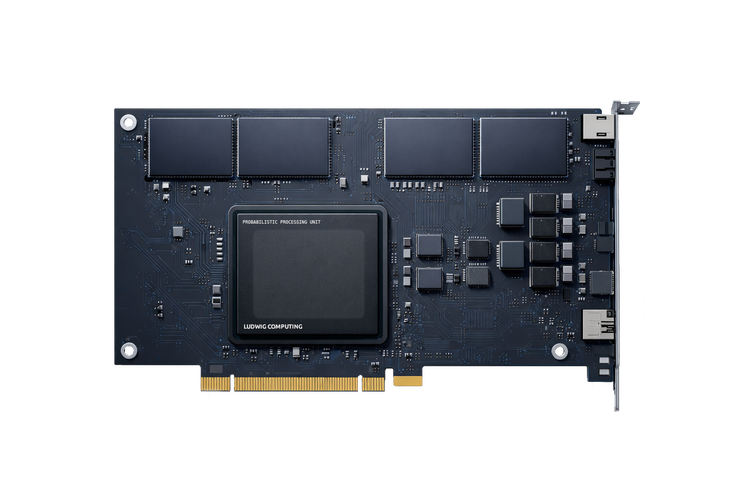
Die Debatte um die Skalierbarkeit künstlicher Intelligenz wird im Wesentlichen an einer Front entschieden: der Hardwarearchitektur. Während die Tech-Welt gebannt auf immer größere Cluster leistungsfähiger Grafikprozessoren (GPUs) blickt, formiert sich im Silicon Valley eine Gegenbewegung. Dort wird das Fundament digitaler Berechnungen selbst infrage gestellt. Prominentestes Beispiel ist das neu gegründete Startup Ludwig Computing, angeführt von Branchenveteranen wie dem ehemaligen Juniper-Networks-CTO Raj Yavatkar. Das Ziel des Unternehmens ist die Etablierung einer völlig neuen Chip-Kategorie – der Probability Processing Unit (PPU).
Klassische Rechenarchitekturen (CPUs und GPUs) basieren auf dem Prinzip des Determinismus. Sie wurden entwickelt, um exakte, reproduzierbare mathematische Operationen durchzuführen. Für traditionelle Software ist dies essenziell. Moderne generative KI-Modelle und Large Language Models (LLMs) funktionieren jedoch fundamental anders. Sie berechnen keine absoluten Wahrheiten, sondern Wahrscheinlichkeiten. Bei der KI-Inferenz – dem Ausführen eines fertig trainierten Modells – geht es im Kern darum, das wahrscheinlichste nächste Wort, Pixel oder Muster vorherzusagen.
Der ehemalige Juniper-CTO und Gründer des Startups Ludwig Computing schreibt auf LinkedIn: “Jede Modellklasse, die derzeit von Bedeutung ist – LLMs, die Token für Token abtasten, Diffusionsmodelle, die Rauschen durch Iteration beseitigen, Bildverarbeitungsmodelle, die probabilistische Wahrnehmung betreiben, sowie Weltmodelle, die RL, Bildverarbeitung und Sprache miteinander verknüpfen – tut im Grunde dasselbe: Abschätzen. Wahrscheinlichkeiten berechnen.”
Abkehr vom Determinismus
Hier setzt das Konzept der PPU an. Ludwig Computing entwickelt Prozessoren, die „probability-native“ sind. Anstatt probabilistische Algorithmen mühsam über deterministische Transistorenstrukturen zu emulieren, bildet die Hardware die probabilistische Mathematik direkt ab.
Der Name des Startups ist dabei Programm und eine direkte Hommage an Ludwig Boltzmann, den Urvater der statistischen Mechanik. Durch das native Rechnen mit Wahrscheinlichkeiten versprechen PPUs, die immense Energie- und Recheneffizienz zu liefern, an der es aktuellen Architekturen mangelt.
Ludwig Computing steht mit diesem Ansatz nicht allein: Auch Akteure wie das finnische Startup Flow Computing oder Alibabas Chip-Sparte T-Head forschen intensiv an PPU-Konzepten, was den Beginn eines breiteren Markttrends signalisiert.
Yavatkar und sein Team will mit Ludwig Computing die Memory-wall durchbrechen: “Wir haben deterministische Rechenmaschinen entwickelt und anschließend ein Jahrzehnt und unzählige Milliarden dafür aufgewendet, Daten hin und her zu transportieren, um sie probabilistisch agieren zu lassen. Das ist die Speicherbarriere. Das ist das Problem des Datentransports. Viele sehr gute Teams arbeiten derzeit daran – größere Caches, schnellere Verbindungen, intelligentere Datenflüsse, In-Memory-Computing und neue Speicherhierarchien. All dies dient dazu, die Speicherbarriere zu überwinden, wobei man jedoch im selben deterministischen Bereich bleibt.“
Für die IT- und Sicherheitsführung in Unternehmen (CIOs und CISOs) sind PPUs damit kein bloßes Nischenthema der Hardware.
Die technologische Abgrenzung: PPU vs. TPU vs. RDU vs. LPU
Um das Potenzial von Ludwig Computings Ansatz zu verstehen, ist eine Abgrenzung zu bestehenden KI-Beschleunigern essenziell. Spezialisierte Architekturen unterscheiden sich fundamental in ihren Einsatzszenarios und in ihrer Funktionsweise:
- Googles TPU (Tensor Processing Unit) ist eine von Google entwickelte, auf die Ausführung neuronaler Netze und Tensoroperationen spezialisierte Beschleuniger-Hardware, die vor allem für KI-Training und -Inferenz in der Cloud optimiert ist.
- SambaNovas RDU (Rapid Data Unit) ermöglicht durch die vollständige Eliminierung der Cache-Hierarchie sowie die direkte, deterministische Datenverarbeitung zwischen Prozessor und Speicher eine hohe Energieeffizienz und Latenzreduktion für KI-Workloads.
- Groqs LPU (Language Processing Unit) ist ein spezialisierter KI-Beschleuniger, der durch deterministische Softwaresteuerung und seine hochgradig parallele Architektur besonders hohe Geschwindigkeiten und Effizienz bei der Inferenz großer Sprachmodelle (LLMs) ermöglicht.
Ludwig Computing strebt eine hardwareunabhängige und kosteneffiziente Lösung für heterogene KI-Workloads an. Statt auf extreme, aber spezialisierte Performance-Metriken (wie reine Tensor-Durchsatzraten oder deterministische Datenverarbeitung) zu setzen, strebt das Startup die vollständige Entkopplung von Logik und Speicher an und setzt auf Standard-Hardwarekomponenten mit einer intelligenten Orchestrierungsschicht.
Die PPU ist als softwarezentrierte, abstrahierte Rechenarchitektur konzipiert. Der Vorteil ist, dass man die bestehende Infrastruktur effizienter für KI nutzen kann. Das hilft, die Kosten zu senken, Vendor-Lock-ins zu vermeiden, und es erhöht die Flexibilität bei der Skalierung.
Konkreter Use Case: Echtzeit-Betrugserkennung im globalen Finanzwesen
Ein primäres Einsatzszenario für PPUs liegt in Bereichen, in denen kontinuierliche, hochkomplexe Risiko- und Wahrscheinlichkeitsbewertungen in absoluter Echtzeit stattfinden müssen – etwa in der globalen Betrugserkennung (Fraud Detection) im Banking.
Das Problem: Große Kreditkartenanbieter oder Online-Zahlungsdienstleister müssen jede Transaktion innerhalb von Millisekunden auf Betrugsmuster prüfen. Klassische KI-Inferenz-Pipelines auf GPU- oder TPU-Basis stoßen hier regelmäßig an architektonische Grenzen. Um die Latenzvorgaben einzuhalten, müssen die verwendeten KI-Modelle häufig stark vereinfacht („quantisiert“) werden. Zudem verbrauchen die dafür benötigten, riesigen Serverfarmen Unmengen an Strom.
Der PPU-Ansatz: In diesem Szenario übernimmt die PPU die Inferenz probabilistischer Risikomodelle (z. B. Bayesianische Netzwerke oder komplexe LLMs zur Verhaltensanalyse). Statt – wie eine herkömmliche GPU – Milliarden exakter Fließkommazahlen zu berechnen, um am Ende einen Prozentwert für das Betrugsrisiko auszugeben, verarbeitet die PPU die Transaktionsdaten (Standort, Betrag, Nutzerhistorie, Tippgeschwindigkeit) direkt als Wahrscheinlichkeitsverteilungen; die Erkennungsrate für hochentwickelte Betrugsversuche erhöht sich signifikant. Da der Umweg über die deterministische Emulation entfällt, sinkt die Anzahl der Transistorschaltungen pro Analyse drastisch, was die Infrastrukturkosten für die Betrugsprüfung pro Transaktion senkt. Ein solches System kann zudem komplexere Zusammenhänge in Echtzeit bewerten sowie deutlich präzisere Modelle nutzen, ohne das strikte Zeitfenster für die Transaktionsfreigabe (z. B. unter 50 Millisekunden) zu verletzen und ohne die Customer Experience durch Verzögerungen im Bezahlvorgang zu beeinträchtigen.
Die CIO-Perspektive: Wirtschaftlichkeit, Technologierisiko und die Post-GPU-Ära
Entlastung der IT-Budgets: Die Betriebskosten (OpEx) für Hosting und Betrieb von KI-Modellen sind derzeit der größte Kostentreiber in den IT-Budgets. GPUs sind teuer in der Anschaffung und extrem energiehungrig. Sollten PPUs ihr Versprechen einlösen und Inferenzprozesse um ein Vielfaches energieeffizienter gestalten, würde sich die Total Cost of Ownership (TCO) von KI-Projekten dramatisch verschieben.
Architektonische Flexibilität und Vendor Lock-in: Der aktuelle KI-Markt leidet unter einer extremen Monopolstellung von NVIDIA. Die Entstehung neuer Chip-Klassen wie PPUs bietet langfristig die Chance, die Abhängigkeit von einzelnen Hardware-Herstellern und deren proprietären Software-Stacks (wie CUDA) zu verringern. CIOs sollten bereits jetzt bei der Auswahl ihrer aktuellen KI-Infrastruktur darauf achten, dass Software-Schnittstellen und Frameworks (z. B. PyTorch) abstrahiert genug sind, um künftig auch neuartige Hardware-Architekturen ohne vollständige Neuentwicklung der Anwendungen integrieren zu können.
Die CISO-Perspektive: Neue Dimensionen der IT-Sicherheit und Governance
Datenschutz und On-Premise-Inferenz: Aufgrund des enormen Bedarfs an Rechenleistung von LLMs weichen viele Unternehmen auf Cloud-APIs der großen Hyperscaler aus. Dies birgt erhebliche Risiken für den Datenschutz und die Compliance (z. B. DSGVO). Effizientere Inferenz-Hardware wie PPUs könnte es Unternehmen erlauben, leistungsstarke Modelle kostengünstig und hochgradig performant im eigenen Rechenzentrum (On-Premise) oder „at the Edge“ (direkt auf Endgeräten) zu betreiben. Für CISOs bietet dies eine historische Chance, die Datenhoheit vollständig zurückzugewinnen.
Resilienz der Lieferkette: Die geopolitischen Risiken rund um die Halbleiterproduktion (insbesondere in Taiwan) stellen ein inhärentes Risiko für jede digitale Unternehmensstrategie dar. Das Aufkommen alternativer Chip-Designs und Anbieter, die potenziell auf unterschiedliche Technologieansätze oder Fertigungsverfahren setzen, diversifiziert das Risiko in der Hardware-Lieferkette.
Verschiebung der Angriffsflächen: Wenn Hardware probabilistisch statt deterministisch rechnet, verändern sich auch die Muster, wie Systeme auf Fehler oder Angriffe reagieren. Klassische Methoden der Code-Validierung und des Debuggings greifen unter Umständen zu kurz. CISOs müssen sich darauf einstellen, dass die Absicherung von KI-Inferenz-Pipelines neue mathematische und statistische Auditverfahren erfordert.
Wichtig für die Beschaffung
PPUs befinden sich in der Frühphase; Ökosysteme, Compiler und Entwickler-Tools für PPUs müssen noch reifen. Die Roadmap für die kommenden drei bis fünf Jahre sollte jedoch Evaluierungsfenster für alternative Hardwarearchitekturen berücksichtigen.
Fazit
Im Kontext von KI-Workloads hat die Halbleiterindustrie die Grenzen der klassischen Von-Neumann-Architektur (ein Referenzmodell für Computer mit einem gemeinsamen Speicher für sowohl Computerprogrammbefehle als auch Daten) erreicht. Ludwig Computing zeigt, dass der Status quo der Hardware-Infrastruktur nicht in Stein gemeißelt ist. Während GPUs das Fundament für das Training von KI-Modellen bleiben, könnte die Zukunft der Inferenz software-defined sein. CIOs und CISOs sind gut beraten, diese Entwicklung technologisch zu antizipieren, um beim Eintritt der Marktreife nicht von agileren Marktbegleitern abgehängt zu werden.